摘要
过去两年,我也花了很多时间研究AI工具、模型、提示词和自动化。但到现在,我反而越来越少专门安排时间“学习AI”。
不是因为AI不重要,恰恰相反,是因为它已经开始真正进入我的工作。我现在更习惯先确定一个真实项目,再让AI参与其中:做网站、处理内容、整理资料、设计服务流程、写脚本、检查文件、处理重复工作。
真实项目很快就会告诉我:哪些能力真正需要学,哪些只是看起来很厉害。
我发现,“学了很多AI”和“真的会用AI”是两回事
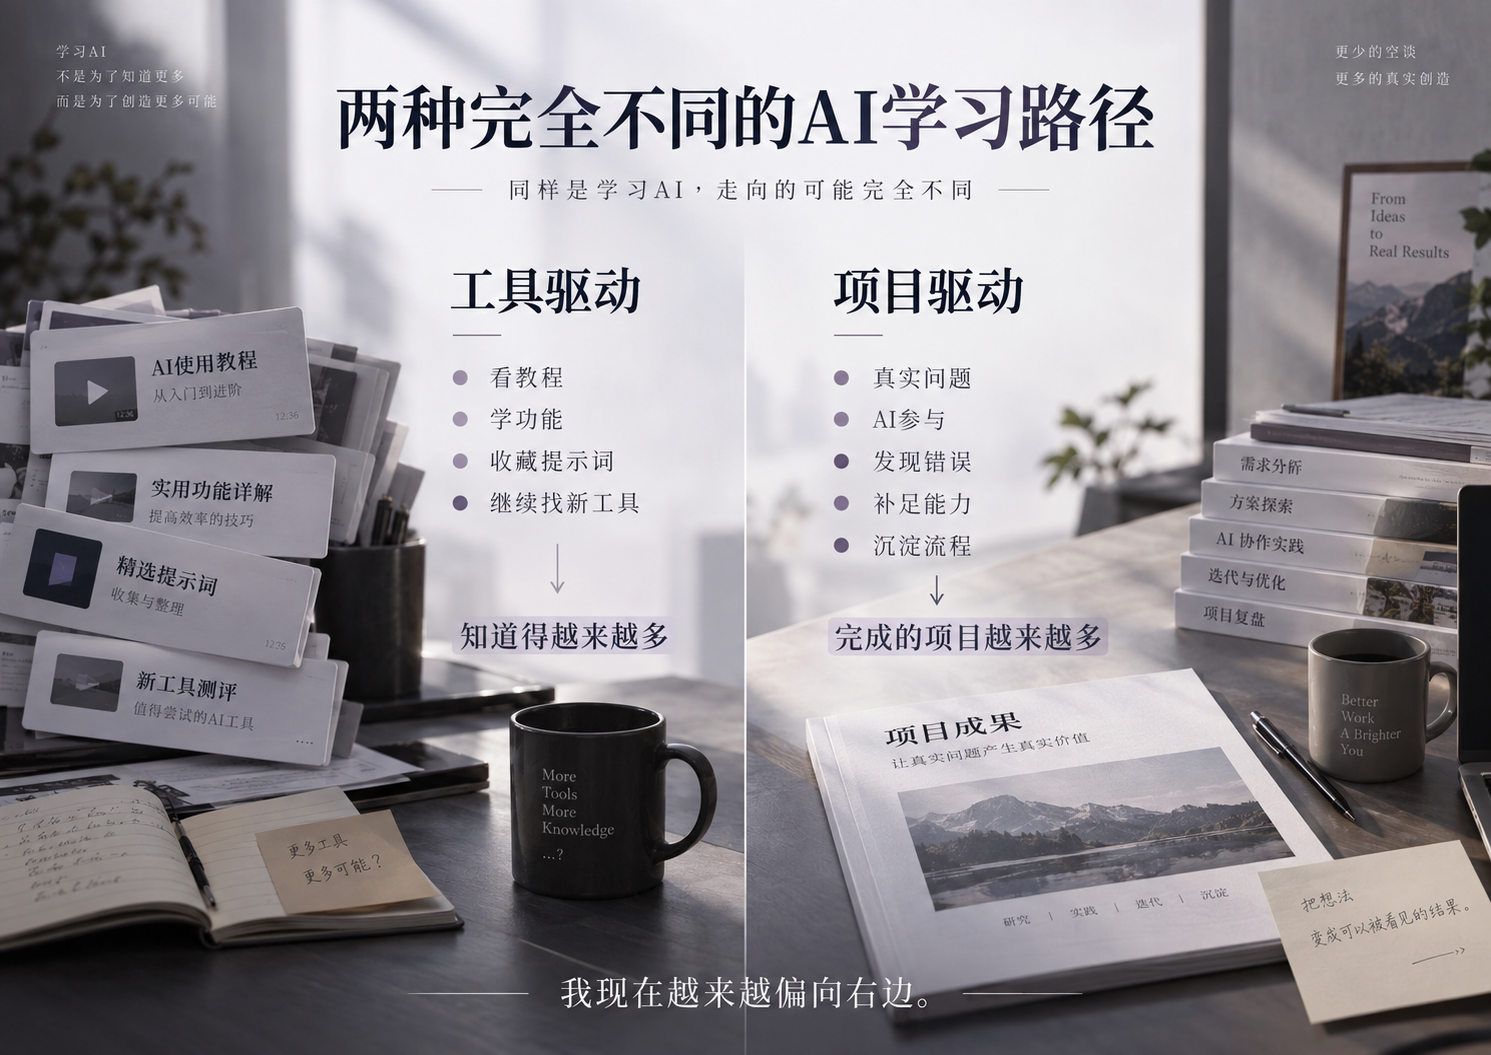
这两年有一种很常见的状态:每天都能看到新的模型、新的Agent、新的工作流、新的提示词方法,于是不断收藏教程、观看演示、尝试新工具。
这些事情当然不是没有价值。
问题是,如果一直以“继续学习AI”为目标,这件事情几乎没有终点。
今天刚刚熟悉一个模型,下个月可能出现新的版本;刚研究完一个工具,另一个产品又加入类似功能。最后很容易变成:认识的AI工具越来越多,真正完成的东西却没有明显增加。
我自己也经历过这个阶段。
后来我的判断逐渐发生了变化:
我不是不学AI了,而是不再把“学AI”本身当成工作成果。
现在如果出现一个新工具,我最关心的问题通常已经不是“它有什么功能”,而是:
它能不能进入我现在正在做的某一个真实项目?
不能,我可能暂时就不研究。
能,我直接拿项目测试。
AI正在从“回答问题”变成“参与工作”
这种变化也和AI产品本身的发展方向有关。
现在的AI已经不只是聊天框里的问答工具。以当前的Agent类产品为例,已经能够围绕文件、代码、工具和应用执行更长的任务。OpenAI目前关于Workspace Agents、Codex以及Agents API的官方资料,也越来越多地强调重复工作流、文件处理、工具调用以及较长周期任务,而不是只有一次性问答。
但对我来说,更重要的不是这些产品名,而是工作方式发生了变化。
以前是:
我做工作 → 遇到问题 → 问AI。
现在越来越接近:
我定义工作 → AI参与执行 → 我检查和修正 → 再继续执行。
看起来只差了一点,实际差别很大。
真实项目会迅速暴露出“教程里没有的问题”
我现在很喜欢直接拿真实项目测试AI,一个很重要的原因,就是它会非常快地暴露问题。
看一个演示视频时,很多东西都显得很简单。
比如一句提示词生成一份报告,一个Agent自动处理几十个文件,一段代码自动完成整个流程。
但真正进入项目以后,你遇到的问题往往完全不同。
文件到底放在哪里?
命名方式是否统一?
哪些文件允许AI修改?
输入信息不完整怎么办?
AI理解错了需求怎么办?
执行到一半报错以后从哪里重新开始?
生成了五十个文件以后,怎么确认没有漏掉三个?
输出“看起来差不多”,但有没有达到真正的交付标准?
客户资料能不能交给AI处理?
哪些步骤必须人工确认?
这些东西很少靠看教程真正学会。
只有项目开始以后,它们才会出现。
EthanUp让我真正理解了“AI工作流”是什么
我在EthanUp上的体验非常典型。
如果只是学习Codex,我完全可以看大量关于提示词、命令、Agent和自动化的教程。
但我后来采用的方法更简单:直接让它进入真实的网站工作。
网站本身是真实存在的,文章目录是真实的,发布流程是真实的,文件结构也是真实的。出了问题以后,不是重新打开一个聊天窗口再试一次,而是必须找到为什么出错,然后继续完成任务。
我此前甚至完整保留过一段约2小时26分钟的操作录屏。
这里面并不是两个多小时“AI完美自动工作”。
相反,它真正有价值的地方恰恰包括中间出现的问题、修改、重新尝试和流程调整。
也是在这种过程中,我才慢慢发现,所谓AI工作流并不是找到一句神奇提示词。
真正重要的是:
上下文怎么给,任务怎么拆,文件怎么组织,权限放在哪里,哪里让AI继续,哪里必须人工确认,失败以后怎么恢复。
这些才是项目能力。
做Fiverr服务以后,我关注的也不再是AI替代率
我在设计Fiverr以及其他可以标准化交付的服务时,也越来越少从“这个AI能做什么”出发。
现在我更习惯从另外一个结构思考:
客户给A → AI或脚本处理 → 人工质检 → 交付B。
比如一个文件处理项目,真正的问题不是AI能不能处理。
而是客户应该给我什么?
什么格式能接?
什么情况不能接?
AI完成以后怎么检查?
哪些错误必须人工发现?
最终应该交付哪些文件?
如果客户要求修改,流程能不能重复?
一旦把这些问题放进去,你就会发现“会使用AI”和“能够卖一个AI服务”之间还有很长的距离。
而这段距离,只能靠真实项目补上。
我现在学习AI的方法其实变得更慢了
这里有一个看起来很矛盾的地方。
把AI直接放进项目,并不意味着学习速度一定变快。
很多时候反而更慢。
因为你不能只停留在“它做出来了”。
你必须知道结果是不是正确。
比如AI写了一段代码,你至少需要知道它有没有修改不该修改的部分;AI处理了一批数据,你需要验证字段有没有错位;AI写了一篇文章,你需要知道里面有没有把推断写成事实。
所以现在我的学习方式更接近:
遇到问题 → 学需要的那一部分 → 回到项目 → 再继续。
而不是:
先把这个工具全部学完 → 以后可能会用。
这两种方法没有绝对的对错。
但对于已经有真实工作的人,我越来越倾向前一种。
一个真实项目,会不断留下新的“资产”
还有一个很大的区别是,纯粹学习通常留下的是知识,而项目会留下资产。
我完成一个项目以后,留下来的可能包括:
- 一套提示词;
- 一个文件结构;
- 一个检查清单;
- 一段脚本;
- 一个SOP;
- 一套命名规范;
- 一个失败案例;
- 一组测试数据;
- 一个可重复使用的Skill;
- 甚至最后变成一套自动化流程。
第一次可能需要两个小时。
第二次可能只需要一个小时。
再往后,它可能变成20分钟,甚至只需要人工做最后确认。
这个时候,AI真正开始产生复利。
不是因为模型突然更聪明了,而是因为你的工作系统越来越完整。
我不建议一开始就追求“全自动”
这是我目前特别明确的一个判断。
很多人一接触AI工作流,就会直接想到无人值守、全自动、一键执行。
我反而越来越谨慎。
如果一个流程你自己都没有稳定做过几次,就很难知道哪里真正容易出错。
所以我现在更倾向于:
先人工完成。
再让AI参与一部分。
发现重复步骤。
把重复步骤标准化。
跑几次。
确认稳定以后,再考虑自动化。
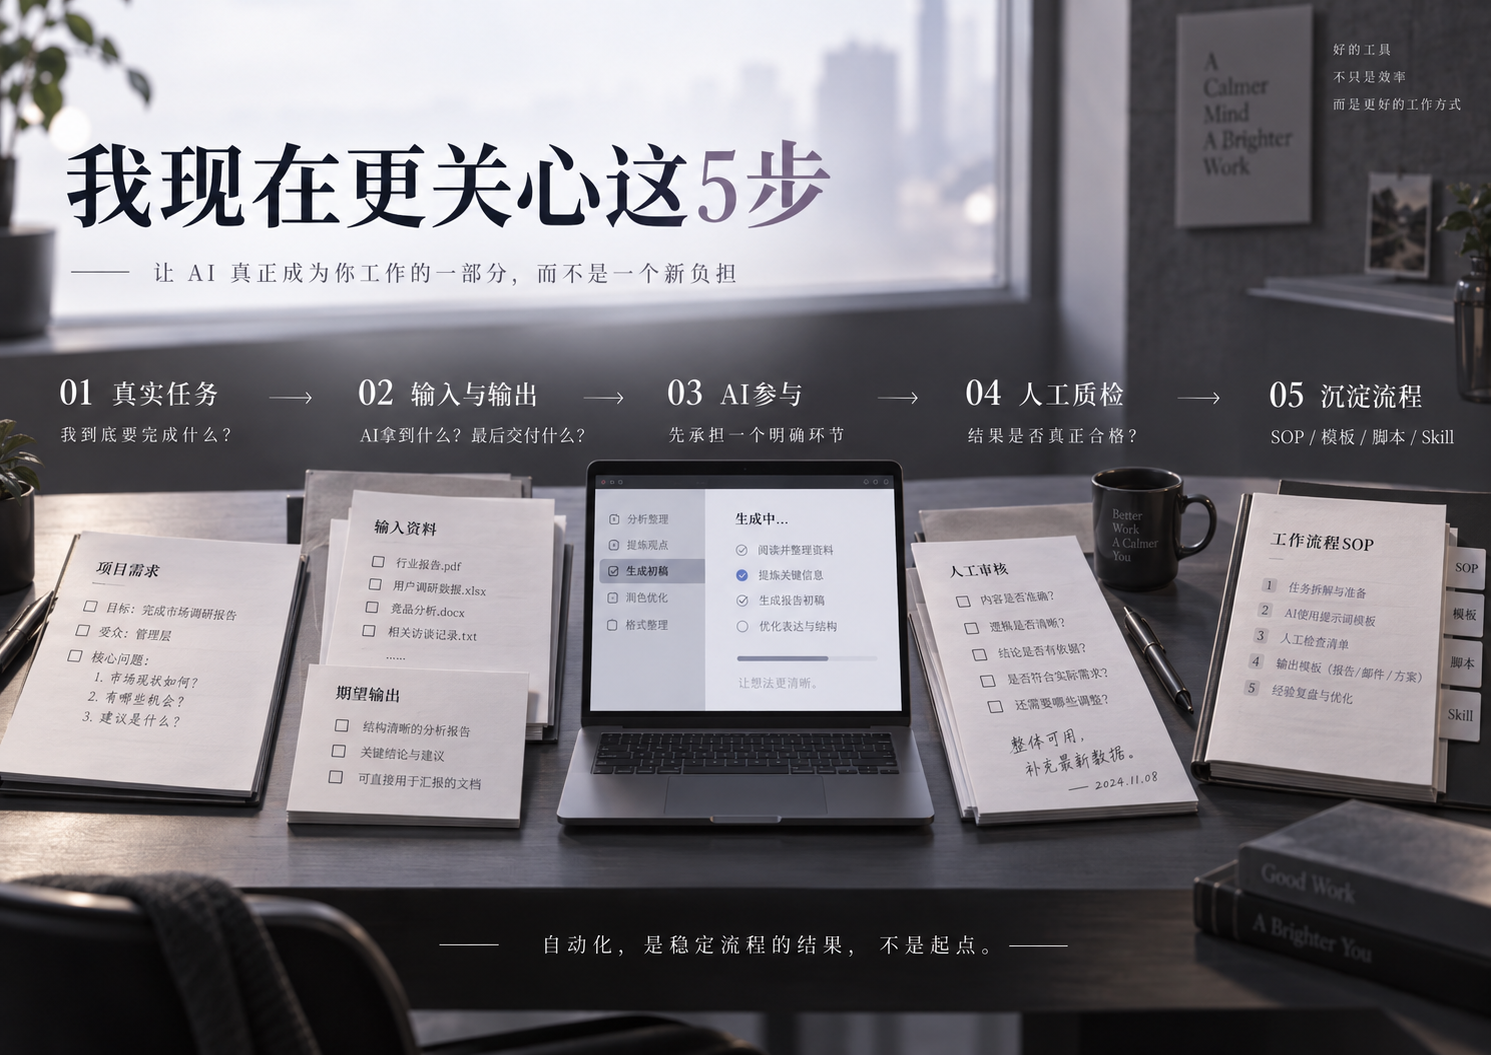
自动化应该是成熟流程的结果,而不是一个项目的起点。
如果普通人想真正开始,我建议先找一个很小的项目
不用一开始搭Agent系统,也不用购买一堆AI工具。
找一件你本来就需要完成的事情。
例如整理30份资料,做一份产品介绍,把10条内容改成几个平台版本,整理一批Excel,把自己的作品建立资料库,或者把每天重复处理的一项工作做成固定流程。
然后先写清楚四件事:
输入是什么?
最终要得到什么?
什么叫做合格?
哪些环节必须自己检查?
接下来再让AI参与。
第一次不要追求自动。
你真正需要观察的是:
它在哪里理解错了?
哪里需要更多上下文?
哪些规则应该提前写进去?
哪些步骤重复出现?
哪些事情其实根本不应该交给AI?
这些答案,最后才会变成属于你自己的AI能力。
什么可以复制,什么不能复制
我现在使用的一些方法,并不能原样复制给所有人。
我的网站结构、内容矩阵、账号数据、设计经验、产品和工作习惯都有自己的背景。别人直接复制我的整个系统,很可能没有意义。
但有一部分方法是可以复制的:
不要先围绕AI寻找事情做,而是先找到真实问题,再判断AI能承担哪一段。
真实项目会提供约束。
约束会产生错误。
错误迫使你建立规则。
规则逐渐变成流程。
流程稳定以后,才可能形成自动化。
这是我这两年对于AI使用方式最大的变化之一。
总结
所以现在有人问我:“应该怎样学习AI?”
如果只是刚刚接触,我仍然建议先了解基本概念和基本操作。
但很快就应该开始做东西。
不要等到把ChatGPT学完、把Agent学完、把Codex学完,再开始项目。
因为它们可能永远学不完。
找一个真实任务,让AI进入其中。
先让它承担20%。
再到30%、50%。
哪些部分适合它,哪些部分必须由你来判断,会在真正工作里越来越清楚。
到那个时候,你学到的就不再只是一个AI工具。
而是一套属于自己的工作方法。